


블로그 글
박재성 선생님이 개발 블로그에 쓴 글입니다.
[실습] 좋아요 수 폭증으로 인한 DB 부하를 Redis로 해결하기 - 2
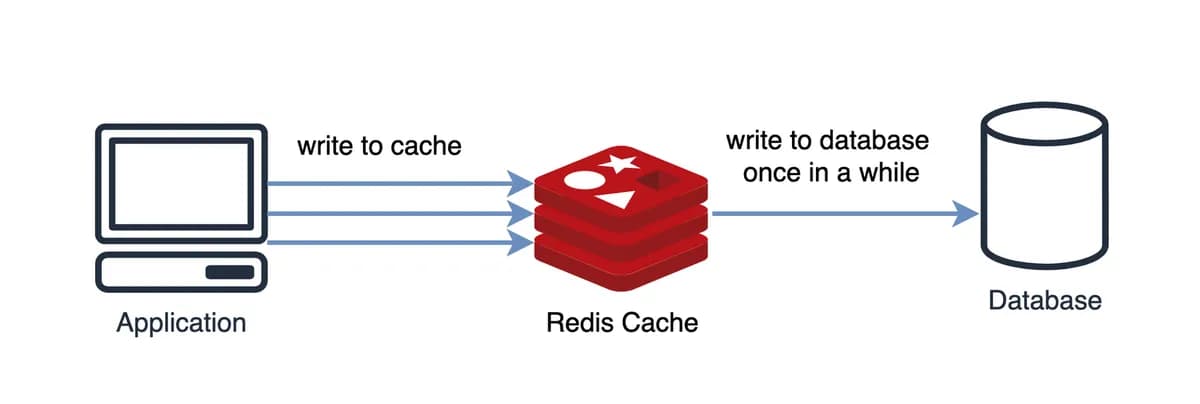
✅ 문제 원인 누군가 좋아요를 한 번 누를 때마다 DB에 계속해서 요청을 보낸다. 만약 1000명의 사용자가 글을 보고 좋아요를 누르면 1000번의 DB 쓰기 작업을 해야 한다. DB 부하의 원인은 크게 2가지이다. 한 번의 요청이 일어날 때마다 매번
[실습] 재고를 차감할 때 동시성 이슈로 인한 오차가 발생하지 않도록 만들기 - 3
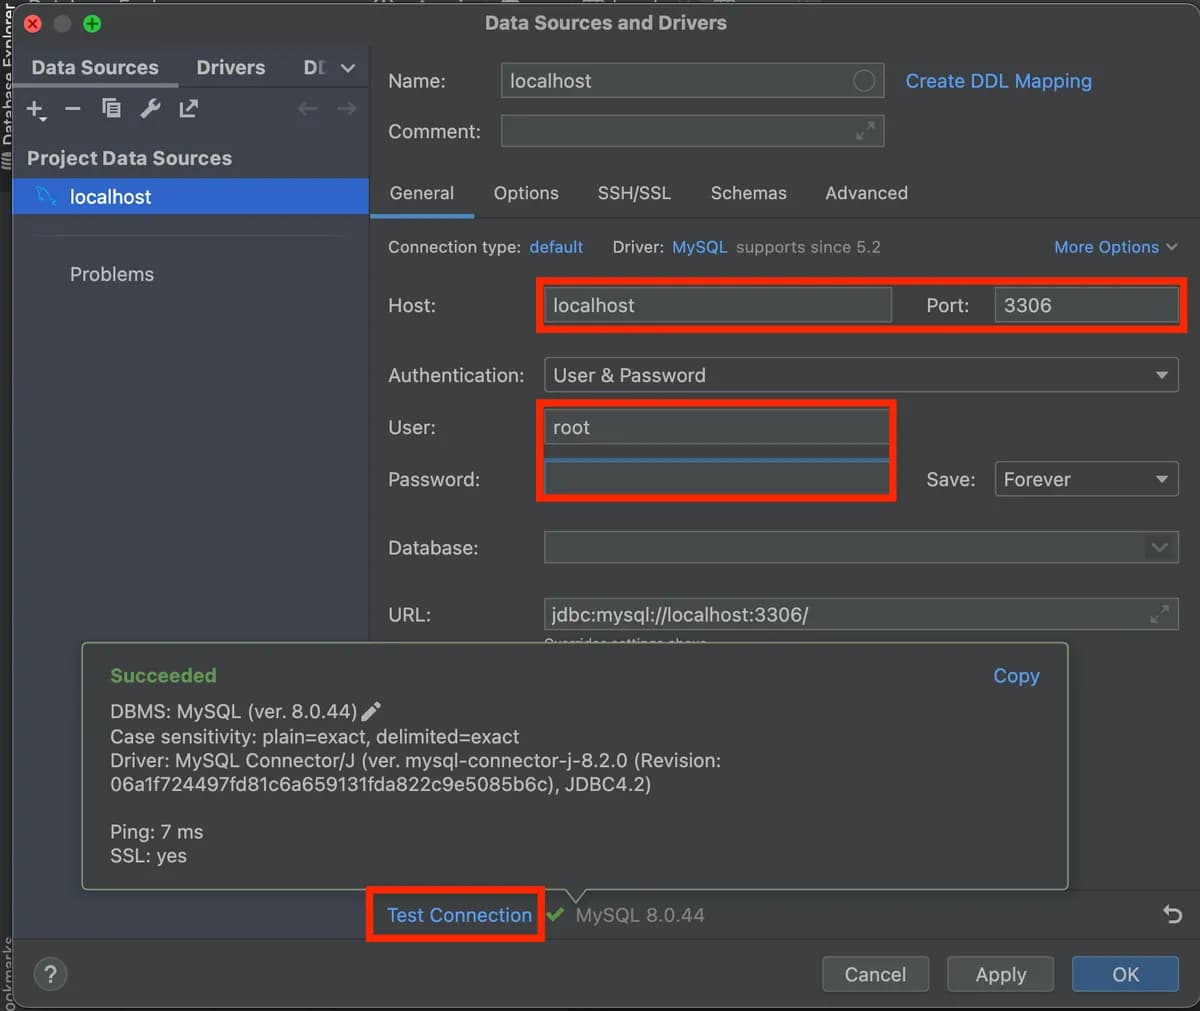
이번 강의에서는 Redis로 Lock을 구현해 동시성 이슈를 해결해보자. ✅ 문제 해결 코드 작성하기 서버 실행시키기 테스트를 위해 DB에 데이터 넣어주기 부하 테스트 스크립트 살펴보기 부하테스트 진행하기
[실습] 재고를 차감할 때 동시성 이슈로 인한 오차가 발생하지 않도록 만들기 - 2
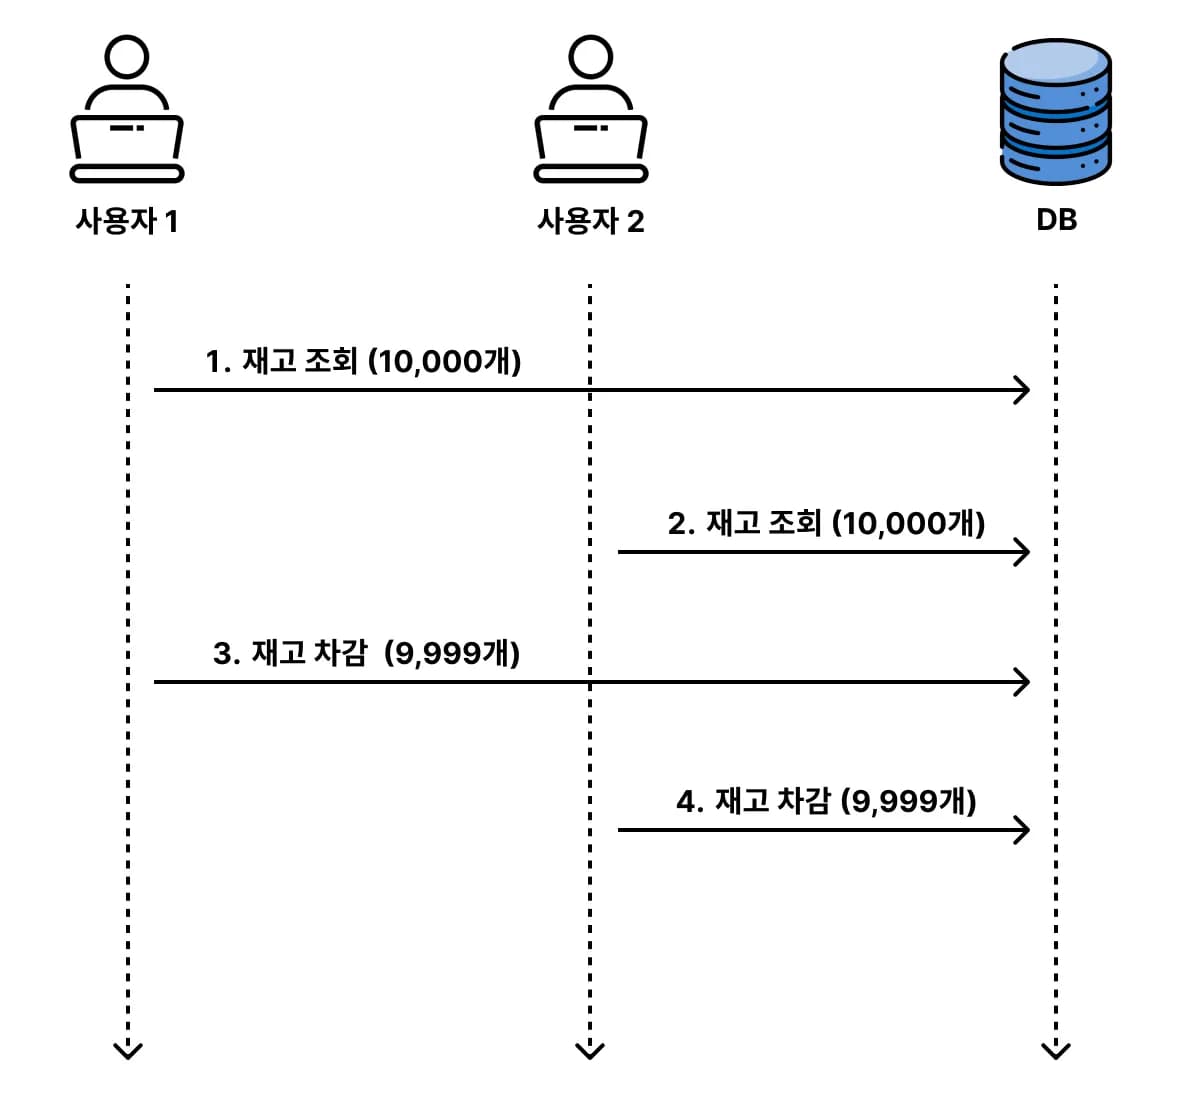
✅ 원인 파악 이전 강의에서 실제 테스트를 해보니 원래 차감되어야 하는 개수보다 적게 차감이 됐다. 한 마디로 재고를 차감할 때 오차가 발생했다. 실제 서비스에서는 이런 문제가 절대 발생하면 안 된다. 이 문제를 해결하기 위해 문제의 원인을 살펴보자.
[실습] 좋아요 수 폭증으로 인한 DB 부하를 Redis로 해결하기 - 1
✅ 문제 상황 ‘비전공자를 위한 Redis 입문/실전 (조회 성능 최적화편)’ 강의에서는 데이터 조회(Read) 작업을 빠르게 만드는 가장 기초적이면서도 강력한 전략인 Cache Aside 전략을 배웠다. 하지만 데이터 쓰기(Write) 작업이 미친
절약 플랜, Budgets, Cost Explorer, Billing and Cost Management, Trusted Advisor (★★
✅ 절약 플랜 (Savings Plan) 절약 플랜이란 AWS 비용을 절감하기 위해 일정 기간 및 사용량을 약정하면 할인된 요금이 적용되는 모델을 의미한다. [유형] 컴퓨팅 절약 플랜 (Compute Savings Plan) EC2 인스턴스 절약 플랜

보안그룹, NACL (★★★)
✅ 보안 그룹(Security Group) 보안 그룹(Security Group)이란 AWS 리소스에 대해 트래픽을 제어하는 기능을 의미한다. AWS 리소스(ex. EC2 인스턴스)를 집이라고 생각한다면, 보안 그룹은 집 바깥 쪽에 쳐져있는 울타리와
Aurora, DynamoDB, ElasitCache (★★★)
✅ Aurora Aurora는 ‘고성능’ 관계형 데이터베이스(RDBMS) 서비스이다. Auror의 대표적인 유형으로는 Aurora MySQL, Aurora PostgreSQL이 존재한다. [기능] Global Database (글로벌 데이터베이스) A
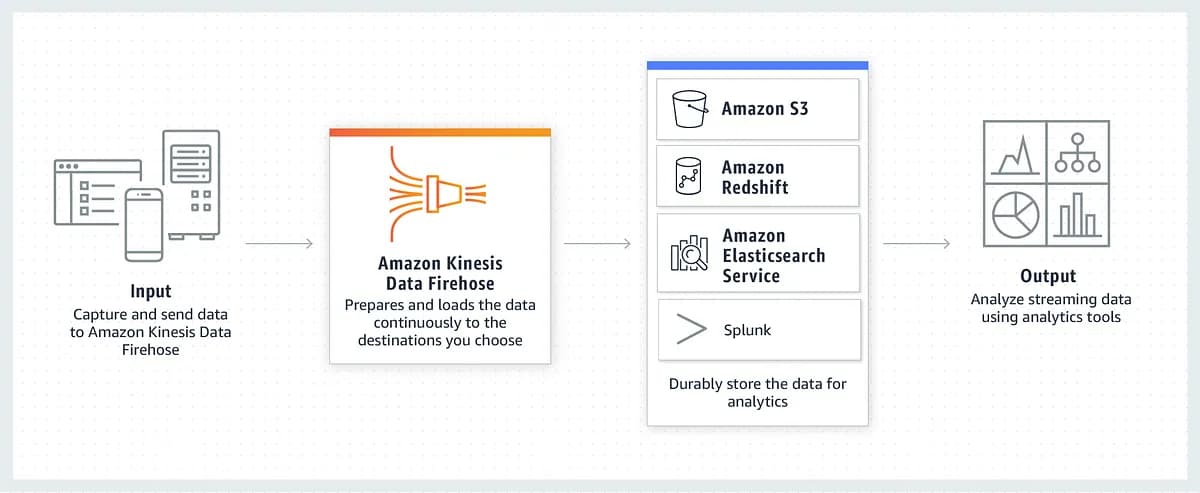
EMR, Spark, RedShift, Athena, Kinesis, Glue, X-Ray, CloudWatch (★★
✅ EMR (Elastic MapReduce) EMR은 빅데이터 처리를 위한 컴퓨팅 서비스이다. ✅ Spark Spark는 대규모 데이터 처리와 분석을 위한 오픈소스이다. [특징] 대규모 데이터를 여러 서버에서 동시에 처리할 수 있는 고속 엔진이다.
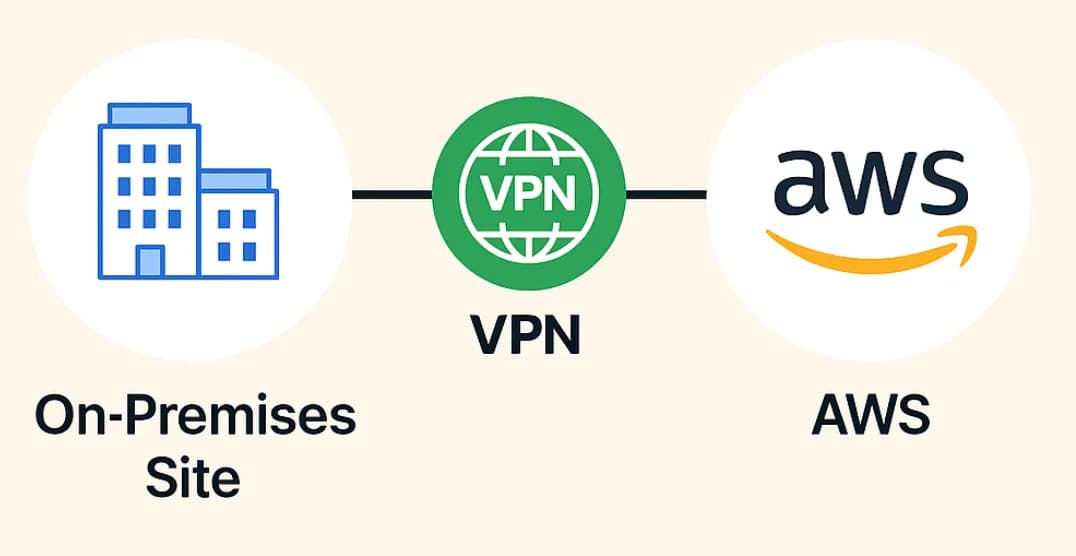
Site-to-Site VPN, Direct Connect, Transit Gateway (★★★)
✅ Site-to-Site VPN Site-to-Site VPN은 인터넷을 이용해 암호화된 터널을 만들어 온프레미스와 AWS의 네트워크를 연결해주는 서비스이다. [암기 Tip] VPN : 암호화 서비스 Site-to-Site : 사이트 간에 연결을 하
ECS, Lambda, Step Functions, API Gateway (★★★)
✅ ECS ECS는 Docker 컨테이너를 쉽게 운영하게 해주는 서비스이다. [유형] EC2 기반의 ECS Fargate 기반의 ECS ✅ Lambda Lambda는 AWS가 서버를 관리하고, 개발자는 코드만 올리면 실행되는 서비스이다. [특징] 서버
RDS, 스토리지 유형, 기능 (★★★)
✅ RDS란? RDS는 관계형 데이터베이스(RDBMS) 서비스이다. 대표적인 관계형 데이터베이스로 MySQL, PostgreSQL이 있다. ✅ RDS 스토리지 유형 범용 SSD 스토리지(gp3, gp2) 프로비저닝된 IOPS SSD ✅ 기능 Multi
IAM, Identity Center, STS, Cognito, CloudTrail (★★★)
✅ IAM (Identity And Access Management) IAM은 AWS 리소스에 접근할 권한들을 관리하는 서비스이다. [기능] IAM 사용자(User) : AWS 서비스를 사용할 특정 사용자 또는 애플리케이션 IAM 역할(Role) :